Блог

  • AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Компания AMD представила технологию «тетраэдральных каркасов» (tetrahedral cages) в области компьютерной графики, способную существенно снизить затраты памяти и вычислительных ресурсов при трассировке лучей в сложных анимированных сценах.

    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

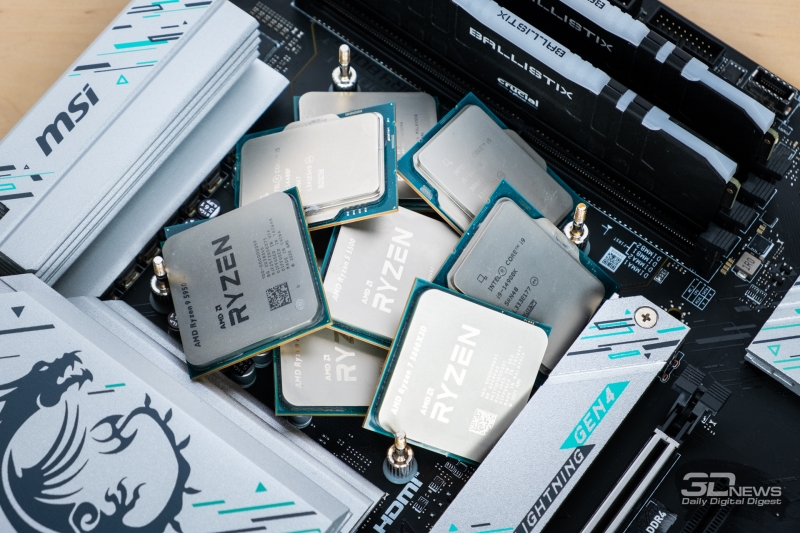
    Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Компьютер месяца — сентябрь 2026 года
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Мастерская локальных ИИ: салат картофельный с Qwen3.8
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    10 флагманских процессоров Intel за 10 лет
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Метод тетраэдральных каркасов позволяет в реальном времени выполнять трассировку лучей для сотен миллионов независимо анимированных треугольников, избегая при этом огромных накладных расходов на структуры ускорения, известные как иерархия ограничивающих объёмов, или BVH, которые обычно сопровождают подобные задачи.

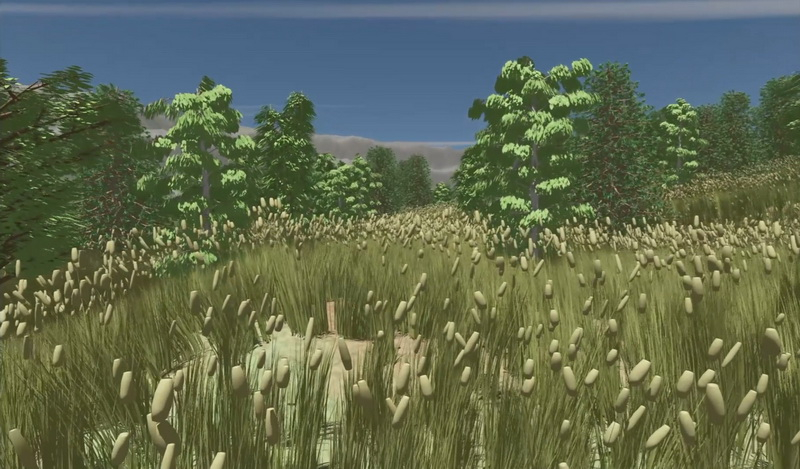
    В новой статье на портале GPUOpen, опубликованной 17 сентября, ведущий специалист AMD Хольгер Грюн (Holger Gruen) продемонстрировал технологию тетраэдральных каркасов на примере масштабной сцены с ландшафтом, содержащей около 25 000 независимо анимированных растений. При максимальном уровне детализации (LOD) эти растения состоят примерно из 2,8 млрд треугольников. После выбора уровня детализации для каждого кадра выполняется трассировка лучей (первичных и теневых) для примерно 500 млн анимированных треугольников. При этом сцена воспроизводится со скоростью более 60 кадров в секунду (FPS) в разрешении 1080p на видеокарте Radeon RX 9070 XT.

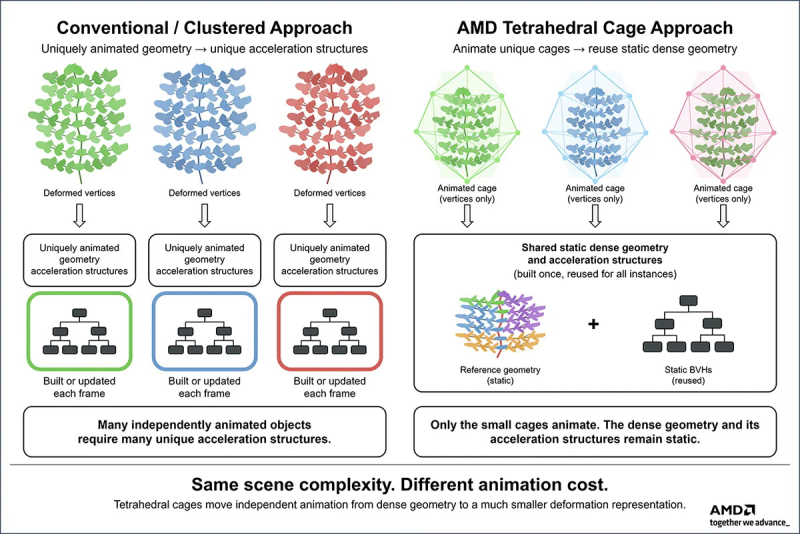
    Однако настоящий прорыв заключается в том, что данная технология радикально сокращает объём используемой памяти и затраты на обновление структур ускорения. В традиционных реализациях трассировки лучей для каждого независимо анимированного объекта требуется поддерживать и обновлять собственную иерархию ограничивающих объёмов (BVH) — структуру ускорения, позволяющую эффективно определять, с какими геометрическими элементами может пересечься луч. По мере усложнения сцены обновление таких структур может требовать непомерно больших вычислительных ресурсов.

    Подход AMD, напротив, предполагает заключение плотной геометрии внутрь сравнительно простых деформируемых тетраэдральных каркасов. Вместо обновления каждой отдельной вершины и связанной с ней структуры ускорения, система анимирует окружающий каркас, в то время как исходная плотная геометрия и её BVH остаются статичными и могут использоваться повторно. Перед проверкой пересечения лучи преобразуются обратно в исходную систему координат геометрии.
    AMD придумала, как в 47 раз уменьшить расход памяти для трассировки лучей

    Это обеспечивает примерно 47-кратное сокращение объёма памяти, занимаемой структурами ускорения (расходы сократились с теоретических 80 Гбайт до 1,7 Гбайт), и более чем 90-кратное уменьшение времени обновления BVH по сравнению с традиционным подходом. Что особенно важно, эти улучшения устраняют два основных «узких места», препятствующих эффективной трассировке лучей в насыщенных анимированными объектами сценах.

    Однако у этого метода есть и свои ограничения. Использование тетраэдральных каркасов не позволяет детально управлять анимацией отдельных вершин, поэтому технология лучше всего подходит для густой листвы, травы, толпы и удалённых персонажей, а не для анимации, требующей точной деформации или изменения топологии сетки. По этой причине метод малопригоден для детализированной анимации лиц персонажей или деформации тел при крупном плане.

    Лежащее в основе технологии исследование, подробно описанное в докладе AMD «Ray Tracing Massive Amounts of Animated Geometry» («Трассировка лучей для огромных объёмов анимированной геометрии»), заняло третье место и было удостоено награды Wolfgang Straßer Best Paper Award на конференции High-Performance Graphics 2026. Компания AMD также разрабатывает примеры использования технологии для DirectX Raytracing (DXR) и библиотеку на C++, состоящую только из заголовочных файлов (header-only), чтобы помочь разработчикам внедрить эту технологию в свои конвейеры рендеринга.

    На данный момент это лишь демонстрация результатов исследования, а не функция, уже реализованная в выпущенных играх. Однако она открывает перспективный путь к созданию геометрически сложных и полностью анимированных окружений, не требующих использования видеокарт с огромным объёмом видеопамяти.

    Было интересно? Скажите об этом Google, чтобы чаще получать ссылки на наши новости про 3d-графика
  • Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

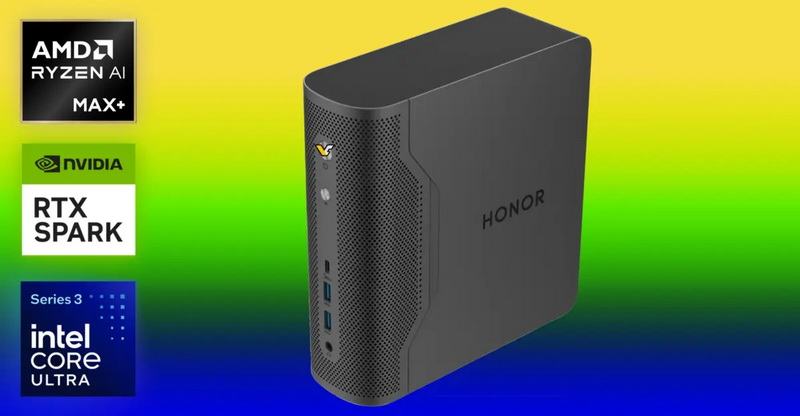
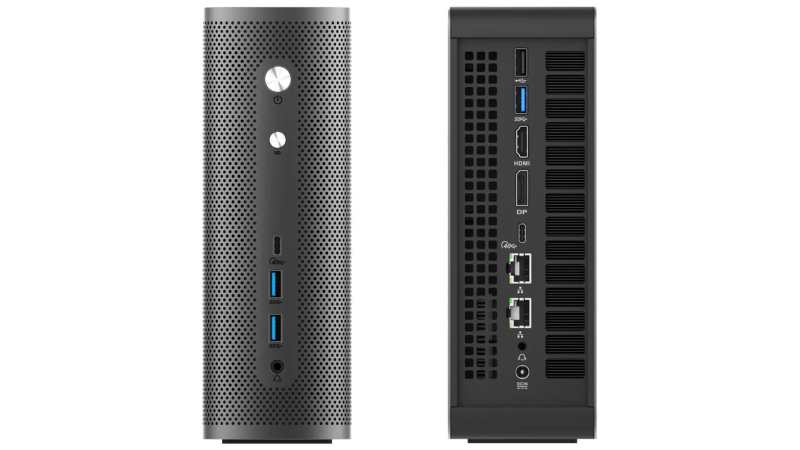
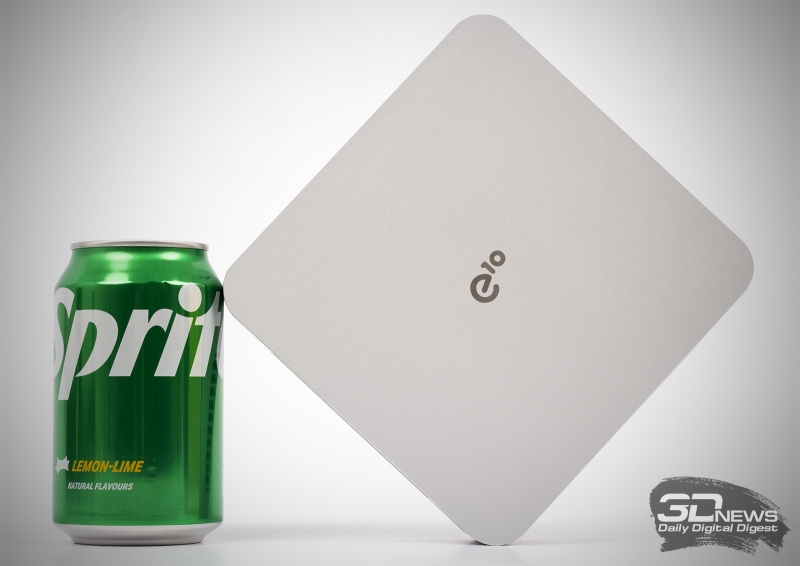
    Компания Honor представила семейство компактных рабочих станций Tiangong AXB35 для задач искусственного интеллекта, включая модель Ultra на базе платформы Nvidia RTX Spark. Этот мини-ПК с внутренним объёмом около 2 литров предлагает 128 Гбайт унифицированной памяти и NVMe-накопитель ёмкостью 2 Тбайт.

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    10 флагманских процессоров Intel за 10 лет

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Компьютер месяца — сентябрь 2026 года

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Мастерская локальных ИИ: салат картофельный с Qwen3.8

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Габариты AXB35 составляют 70 × 192 × 203 мм, а вес — около 1,5 кг. Система поддерживает три режима энергопотребления (55, 85 и 132 Вт) и использует внешний блок питания мощностью 240 Вт. Во всей линейке мини-ПК AXB35 применяется единый формат корпуса.

    Модель AXB35 Ultra базируется на платформе Nvidia RTX Spark, комплектуется 128 Гбайт памяти и NVMe SSD на 2 Тбайт. Honor заявляет для новинки производительность в задачах ИИ до 1 Пфлопс (в формате FP4) и отмечает, что мини-ПК предназначен для работы с мультиагентными системами и крупными локальными корпоративными моделями ИИ. В качестве ориентира компания приводит возможность развёртывания ИИ-модели с 300 млрд параметров, однако уточняет, что реальные возможности зависят от квантования, длины контекста, степени параллелизма и используемого программного обеспечения.

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Платформа RTX Spark объединяет графический процессор (GPU) архитектуры Nvidia Blackwell RTX и центральный процессор (CPU) Grace. Конфигурация для настольных систем включает до 6144 ядер CUDA, 20-ядерный процессор Arm и до 128 Гбайт унифицированной памяти LPDDR5X. Nvidia оценивает энергопотребление чипа для настольных ПК в пределах 140 Вт, а вычислительную мощность — в 1 Пфлопс (FP4).

    В рамках серии мини-ПК компания Honor также предлагает версии AXB35 в комплектациях Standard и Pro. Модель Standard оснащена процессором Intel Core Ultra X7 358H, 64 Гбайт ОЗУ и SSD на 512 Гбайт, тогда как версия Pro использует чип AMD Ryzen AI Max+ 395, 128 Гбайт оперативной памяти и накопитель ёмкостью 1 Тбайт. Производительность системы на базе Intel достигает 180 TOPS, а конфигурации на базе AMD — 126 TOPS.

    Honor выпустила 2-литровую рабочую станцию с Nvidia RTX Spark и 128 Гбайт памяти

    Набор внешних интерфейсов мини-ПК включает два 10-Гбит сетевых порта, Wi-Fi 7, два USB4, четыре USB-A, а также разъёмы HDMI 2.1 и DisplayPort 1.4. Объём постоянной памяти можно увеличить благодаря наличию трёх слотов M.2.

    Для компактных рабочих станций Tiangong AXB35 производитель заявляет поддержку операционных систем Windows 11 и Ubuntu. Информации о стоимости представленных конфигураций мини-ПК пока нет, как и данных о том, когда они поступят в продажу. На сайте Tiangong потенциальным покупателям предлагается обращаться непосредственно в Honor для уточнения конфигураций системы.

    Было интересно? Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект

  • Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Призывы к замедлению темпов развития ИИ ради обеспечения общественной безопасности не мешают руководству Anthropic пристально следить за конкурентной обстановкой на рынке. По данным Reuters, ещё до запланированного на ноябрь IPO стартап собирается представить новую ИИ-модель, которая сможет бросить вызов GPT-6 Astra компании OpenAI.

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Компьютер месяца — сентябрь 2026 года

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Мастерская локальных ИИ: салат картофельный с Qwen3.8

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    10 флагманских процессоров Intel за 10 лет

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то

    Anthropic до IPO собирается выпустить ИИ-модель, которая станет ответом на OpenAI GPT-6 Astra

    Выпущенная в этом месяце GPT-6 Astra набирает популярность среди корпоративных клиентов OpenAI, и это всё сильнее беспокоит конкурирующую Anthropic. Последняя не заинтересована в том, чтобы её статус на рынке ИИ ставился под сомнение действиями конкурента. При этом сама Anthropic не может поставить под удар свою репутацию, спешно выпустив новую ИИ-модель и не убедившись в её безопасности, особенно после недавно развёрнутой генеральным директором Дарио Амодеи (Dario Amodei) кампании по добровольному замедлению темпов развития рынка с целью повышения общественной безопасности.

    Одновременно участники рынка сталкиваются с давлением инвесторов в части сроков окупаемости своих вложений в ИИ-отрасль, поскольку рост ставок по кредитам делает ожидание выхода на окупаемость более тягостным. При этом конкуренцию американским разработкам всё активнее составляют китайские, которые стремительно сокращают отставание от них, а также предлагают более гибкие модели оплаты и интеграции ИИ-систем в бизнес-процессы и инфраструктуру клиентов. В текущих условиях Anthropic важно показать, что она не теряет хватку в конкурентной борьбе, но при этом не пренебрегает безопасностью и одновременно формирует предпосылки для более успешной монетизации своих разработок.

    Исторически именно Anthropic занимала более крепкие позиции в корпоративном сегменте рынка, но OpenAI переориентировала свой бизнес, чтобы ускорить монетизацию своих продуктов при поддержке корпоративных клиентов. Представленные в начале сентября модели семейства GPT-6 Astra хорошо зарекомендовали себя в области кибербезопасности, разработки ПО и управления работой ПК. По данным платформы Ramp, моделям семейства Astra удалось оттянуть на себя до 13 % расходов корпораций в сегменте, тогда как Anthropic с её Claude Fable могла довольствоваться только 8 %. По доле генерируемого разработчиками трафика на OpenRouter модели Astra также впервые вышли вперёд буквально на прошлой неделе, как отмечает Reuters.

    Приведённая к году величина выручки Anthropic по состоянию на конец июля достигала $65 млрд, в 2028 году компания рассчитывает увеличить её до диапазона от $190 до $200 млрд. OpenAI заглядывает в своих презентациях для инвесторов ещё дальше, рассчитывая поднять выручку к концу 2030 года до $350 млрд, но при этом не скрывая, что продолжит оставаться глубоко убыточной к этому моменту. Инвесторы морально готовы к тому, что лидер на рынке ИИ-моделей будет постоянно меняться, поскольку Google DeepMind и другие участники рынка тоже не собираются уступать Anthropic и OpenAI.

    Угрозу для бизнес-модели Anthropic и OpenAI одновременно представляют и модели с открытыми весами или исходным кодом, которые особенно активно продвигаются китайскими разработчиками. К тому же, они позволяют клиентам развивать ИИ-системы на собственных вычислительных ресурсах, без необходимости передавать чувствительную информацию в «облако». Некоторые из крупных клиентов указанных стартапов сами ведут профильные разработки, как та же компания Meta✴ Platforms, не скрывающая собственных намерений перейти на «доморощенную» инфраструктуру. С одной стороны, эти факторы заставляют инвесторов нервничать. С другой стороны, конкуренция стимулирует прогресс в отрасли ИИ.

    Было интересно? Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект

  • Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

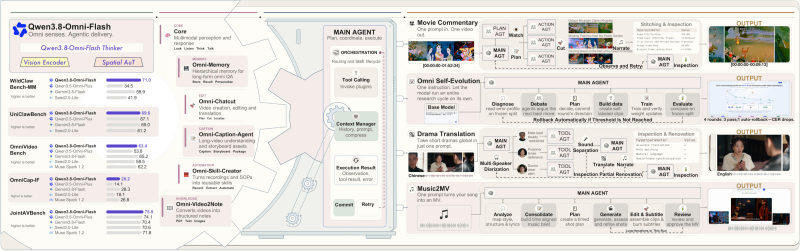
    Alibaba пополнила арсенал моделей искусственного интеллекта мультимодальной системой Qwen3.8-Omni-Flash. В рамках единой архитектуры она обрабатывает текст, изображения, аудио и видео, а также поддерживает контекстное окно размером 1 млн токенов. Новинка, отмечает разработчик, показывает высокие результаты в различных сценариях, включая редактирование видео, подготовку музыкальных клипов, кинопроизводство, обобщение аудиовизуальной информации и ведение диалогов в реальном времени.

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Мастерская локальных ИИ: салат картофельный с Qwen3.8

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Лучший процессор под DDR4 в 2026 году: AM4 против LGA 1700

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    10 флагманских процессоров Intel за 10 лет

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Обзор смартфона Samsung Galaxy Z Flip8: исчезающий вид?

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Компьютер месяца — сентябрь 2026 года

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Обзор смартфона Google Pixel 11 Pro: когда надо выпустить хоть что-то

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Компьютер месяца, спецвыпуск: выбираем мини-ПК для работы и развлечений в эпоху дефицита чипов памяти

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    В помощь студенту: обзор российских ИИ-сервисов для учёбы и закрепления знаний

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Одним из главных достижений стало снижение стоимости сервиса. По сравнению с предыдущей версией Qwen3.5-Omni-Plus при доступе по API цена за час обработки аудиоданных снизилась более чем на 98 %, аудио и видео — более чем на 93 %. Средний результат в 29 бенчмарках вырос более чем на 25 % по сравнению с предыдущим поколением. В тестах, охватывающих работу аудио- и видеоагентов, написание кода и выполнение задач с долгосрочным планированием, модель набрала 71,0 балла в WildClawBench-MM — на 36,5 балла больше предшественницы. В UniClawBench результат составил 69,6 балла. В тесте LongAudioSpan на понимание длинных аудиозаписей модель получила 82,7 балла, в OmniVideoBench на анализ аудио и видео — 63,4 балла, в OmniCap-IF на следование инструкциям при описании видео — 28,2 балла, а в AliMeeting на расшифровку совещаний на китайском языке с участием нескольких человек — 89,7 балла.

    По качеству совместной обработки звука и видео Qwen3.8-Omni-Flash приблизилась к Google Gemini 3.8 Flash, а при работе только со звуком даже превзошла американского конкурента. Система распознавания речи поддерживает 74 языка и диалекта, включая кантонский, уйгурский и маори, а система генерации — 29 языков. Обе системы поддерживают китайский, английский, корейский, французский, немецкий, испанский и японский языки.

    Одной из основных особенностей модели стал механизм «агентного понимания» аудио и видео. Модель не анализирует многочасовую запись последовательно от начала до конца, а, исходя из сути запроса, сама решает, «куда смотреть и что слушать», постепенно сужая область поиска в несколько этапов. В OmniVideoBench этот механизм помог повысить результат с 63,4 до 67,8 балла, а число расходуемых на один запрос токенов сократилось со 145 736 до 79 117, или на 45,7 %. Современные решения, подчеркнули в Alibaba, плохо справляются с продолжительными аудио- и видеозаписями: программные средства для ИИ-агентов пока не имеют полноценной встроенной поддержки этих форматов, а соответствующие механизмы находятся лишь на начальном этапе развития.

    Alibaba выпустила всеядную модель Qwen3.8-Omni-Flash с контекстом на 1 млн токенов

    Alibaba также провела эксперимент, в ходе которого Qwen3.8-Omni-Flash использовалась для разработки другой модели ИИ. Ей поставили задачу за 12 часов улучшить распознавание сычуаньского диалекта китайского языка более компактной моделью Qwen2.5-Omni-3B. «Старшая» модель самостоятельно отобрала тестовую выборку, замерила исходные показатели и сформировала набор обучающих данных. За четыре серии экспериментов она создала 3413 обучающих примеров, благодаря которым доля ошибок при распознавании отдельных символов снизилась с 25,79 до 15,30 %, то есть на 40,7 %. Таким образом, ИИ-агенты могут не только пользоваться другими моделями, но и самостоятельно улучшать их.

    Помимо самой модели, разработчик обновил сопутствующие программные средства. Набор плагинов Qwen-MM-Plugins для работы со звуком и видео получил средства контекстного поиска по медиаданным, подключения внешних инструментов и последовательной обработки продолжительных аудио- и видеофайлов. Поддерживаются различные среды для работы ИИ-агентов, включая OpenAI Codex, Anthropic Claude Code, Alibaba Qwen Code и Google Gemini CLI.

    Компания также выпустила Qwen-Live Harness с открытым исходным кодом — среду для создания интерактивных приложений на базе API Qwen3.8-Omni-Flash-Realtime. Она поддерживает протоколы WebSocket и WebRTC и обеспечивает низкую задержку. По утверждению Alibaba, это первая мультимодальная модель с функцией «звуковой локализации»: объединяя данные пространственного аудио с визуальной информацией, она умеет определять направление и расстояние до источников звука.

    Qwen3.8-Omni-Flash создаёт клипы на основе музыкальных композиций, готовит переводы коротких сериалов и комментарии к полнометражным фильмам, составляет PDF-конспекты обучающих видео и осваивает новые навыки по видеодемонстрациям. При переводе модель может сохранять индивидуальные особенности оригинального голоса. Доступ к Qwen3.8-Omni-Flash открыт через корпоративную ИИ-платформу Alibaba Qianwen AI.

    Было интересно? Скажите об этом Google, чтобы чаще получать ссылки на наши новости про искусственный интеллект